

Adyen 的 CTO 说,公司有大约 1,400 名开发者,一年要消耗约一万亿 Token。过去三个月,这个数字又翻了四倍,Adyen 已经开始为一年消耗十万亿 Token 做准备。
他们的 Token 花在哪里了?要干什么?
Adyen 的这一万亿 Token,主要是工程团队烧掉的,再看看其他支付公司,Token 还花在审核商户、回答客服、处理拒付、阅读邮件和调查异常上。
钱如流水,Token 亦是。
人坐在那里没动,Token 一直在跑
过去 90 天,AI 在 Adyen 编辑了大约 100 万个文件,参与完成了 2 万次 Git commit。公司的人均 merge request 增长了 48%,工程师自己估计,AI 帮他们节省了约 15% 的时间。Adyen 认为花在 Token 上的钱,大概获得了两倍回报。
他们讲了一个例子,Adyen 有一组负责请款、对账和卡组织报表的支付后台系统,里面有大约 2,000 个生产任务,涉及四十多个卡组织。原来的系统全挤在一个很大的部署镜像里,Adyen 想把它拆开,让每个卡组织有自己独立的镜像。
按照以前的做法,这个项目要拉上多个团队,做 6 到 12 个月。最后,两名工程师配合 AI,两个月做完了,而且没有发生事故。
这大概就是 Coding Agent 消耗 Token 的方式。它不是帮你补两行代码就走了,而是要先读代码、读文档、找依赖、运行测试;测试失败以后,再读报错、修改代码、重新运行。一个人同时开几个 Agent,它们就在后台不断重复这些过程。人坐在那里没动,Token 一直在跑。
Stripe 也说过他们91% 的工程师已经在日常工作里使用 AI(不知道9%为什么还没有被裁),内部 Coding Agent `minion` 每周会向生产环境提交超过 1,000 个 PR。仅 2026 年 3 月,Stripe 就有超过 57,000 个 PR 使用了 AI Coding Assistance,三个月增长 140%。
Block 也差不多,大约 7,500 名员工每周使用 AI,超过 90% 的代码提交有 AI 参与,人均每周代码变更数量增加了 30%。
目前看,支付公司很大一笔 Token 账单来自工程部门。支付行业用 AI,不只是从零写新代码,更现实的用途是帮人类爬屎山。支付系统太大,历史代码太多,还要兼容银行、卡组织和各地的支付方式。过去这些复杂性主要消耗工程师的时间,现在 AI 也被拉来一起爬,消耗的是 Token。
找文档、写广告、读合同,都在烧 Token
写代码只是公司内部使用 AI 的一部分。一家规模稍微大一点的 Fintech,每天还有很多时间花在找资料上:报销政策在哪里?这个数据归哪个团队管?某个系统的权限去哪里申请?休假应该找谁?公司越大,文档越多;文档越多,越容易找不到。
Nubank 大约有 9,000 名员工,不同团队把自己的流程和文档放在 Confluence 里。员工遇到问题时,可能要自己翻半个小时;实在找不到,就开一张工单,等上几个小时。Nubank 后来做了一个叫 AskNu 的内部工具,员工直接在 Slack 里提问。AskNu 先判断问题属于哪个部门,再去对应的 Confluence 文档里找答案,最后由大模型整理成一段回复,并附上原始链接。
上线六个月以后,AskNu 有 5,000 名用户,处理了 28 万条消息。Nubank 称,它让部分内部的工单减少了 96%。原来可能要找 30 分钟、或者开工单等 8 小时的问题,现在平均 9 秒得到回答。
AskNu 不会直接帮客户转账,也不会多处理一笔支付,却会不停读取问题、检索文档、整理答案。公司里每个人每天问几次,Token 就这样一点一点堆起来了。
内容团队也一样。Chime 给自己的内部内容模型起了一个很直白的名字:ChimeGPT。它还做了一个“brand brain”,把过去的品牌故事、用户反馈、活动效果和社区讨论放进去。市场团队用它生成不同版本的内容和个性化 onboarding 流程,再经过品牌、法务和合规审核。
Chime 披露,内部团队的内容产量同比增长超过 300%,制作时间缩短了 60%。原来从创意到 campaign 要十小时的工作,现在大约四小时可以完成,测试量增加了三倍。Klarna 的组织数据也很有意思:90% 的员工每天使用生成式 AI,传播、市场和法务团队的使用率分别达到 93%、88% 和 86%。
写代码会消耗 Token,写广告、翻译材料、总结会议、读合同、回答同事的问题,也会。
“香槟色连衣裙”,不等于卖酒
支付公司每天都在做一件有点像查户口的事:这个人是谁?卖的到底是什么?我们敢不敢让他进来收钱?
商户当然不会老老实实按照支付公司的表格介绍自己。线索散在官网、商品页面、注册文件和新闻里,还可能写着不同的语言。以前的系统没有那么多耐心,最简单的办法就是查关键词。
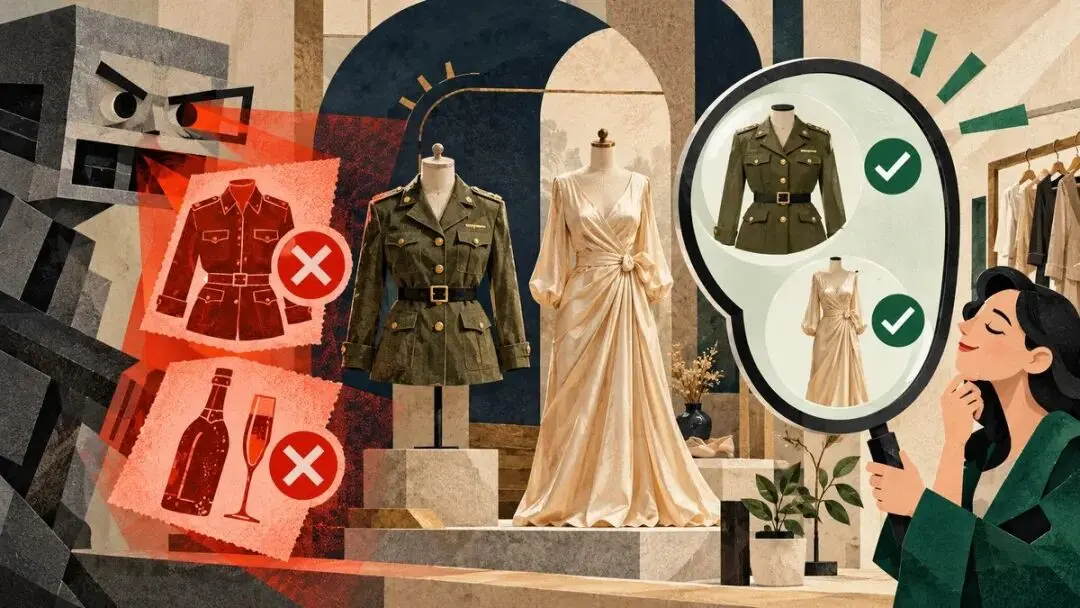
Airwallex 举过一个很好笑的例子。一个商户卖的是 “military-style jacket”,系统看到 military,可能怀疑他在卖违禁军品;另一个商户写着 “champagne-colored dress”,系统看到 champagne,又可能把人家当成卖酒的。
人一眼就知道,军装风夹克不是军火,香槟色连衣裙里也没有香槟。但关键词不懂颜色,也不懂时尚,它只知道这个词看起来有点危险。
这正好是大模型比较会做的事情:不要只盯着一个词,先把前后内容读完,再看看商户到底在卖什么。Airwallex 说,把生成式 AI 加进 KYC 以后,相关环节的误报平均减少了 50%,不用人工介入、可以直接完成 onboarding 的客户增加了 20%。
Stripe 也从 2023 年开始把 LLM 用在商户 onboarding 上。它不是让大模型批准所有商户,而是先处理开放、非结构化的信息,把明显符合要求的申请快速放过去。Stripe 超过 80% 的“可支持商户”可以即时自动通过。Checkout.com 的 policy review,则从 60 分钟缩短到了 10 分钟。
以前员工要自己打开网页、阅读材料、查政策、写结论,现在换成大模型先读一遍,把需要人看的地方挑出来。这里烧掉的 Token,换回来的是少一点误报、快一点开户,以及让内部人员少看一点根本没有问题的材料。
一杯五美元的咖啡,也要过一遍财务
支付公司帮别人处理钱,自己内部照样要报销、审费用、追发票和做账。这可能是最不起眼的一类 Fintech AI 产品。员工刷公司卡买了一杯咖啡,后面可能要上传小票、补用途、选择费用类别;经理要确认是不是为了工作,财务还要检查政策、做会计编码,再同步进 ERP。金额可能只有五美元,处理它的人力成本反而更高。
Ramp 做了一个 Policy Agent,专门审这类支出。它会检查小票和交易能不能对上、有没有重复报销、用途写清楚没有、是否违反公司政策,以及员工最近有没有异常消费。符合政策的可以自动建议通过,有问题的再交给人。Ramp 称,早期客户把人工审核减少了约 85%,费用政策执行准确率超过 99%,最终批准权仍然留在审核人手里。
Brex Assistant 做的事情更琐碎。它会自动找小票、写 memo、填费用类别和参会人,遇到不合规的支出,还会主动追问员工。Brex 举过一个例子:小票上可能没有写 “alcohol”,只写了 “vodka”。以前的关键词规则不一定看得出来,大模型知道伏特加也算酒。
这种活很适合拿 Token 来换时间。
AML 分析师,大部分时间不是在抓坏人
支付公司每天会产生大量风险提醒。真正可疑的交易可能不多,但每一条提醒都要有人打开、查客户资料、看历史交易、检查关联账户,再写一段为什么关闭或者为什么升级调查。很多 AML 分析师的时间,并不是花在抓坏人上,而是花在证明这个人暂时看起来不像坏人。
Nexo 使用 Unit21 的 AI Agent 做初步的 alert review。Agent 会整理交易和账户信息,分析地址之间的关系,生成调查摘要和处理意见。分析师不再从空白页面开始,而是检查 AI 给出的材料和结论。
Unit21 与 Nexo 发布的 case study 里提到,Nexo 的误报比原来的内部系统减少了 93%,目前 57% 的 alert review 已经由 AI 自动完成,目标是提高到 80%。这组数字要打个括号:它来自供应商和客户共同发布的案例,不是独立审计结果;Unit21 也没有公布每次调查消耗多少 Token。
不过,这个案例把 AI 在 AML 里能干什么说得很清楚:机器把材料找齐,把关系画出来,把 narrative 写好;人来判断它是不是真的可疑,以及要不要向监管机构报告。
客户只问了一句:“我的钱呢?”
支付公司的客服,有时候不是“帮我改一下密码”那么简单。客户问一句“为什么钱还没到账”,后面可能牵涉收单行、卡组织、发卡行、币种转换、结算周期、退款状态和账户限制。客服要去好几个系统里查,再把查到的东西拼起来,才能回答一句人话。
AI Agent 做这件事,也要经历同样的过程:先理解问题,查询交易,检索规则,判断下一步,再生成回复。每查一次系统,结果都要重新送回模型,Token 就这样一轮一轮地消耗掉了。
Checkout.com 说,大约 60% 的客服请求是简单、重复的问题,公司预计 2026 年 AI Agent 可以独立解决超过一半的客服量。Block 披露,Cash App 大约 65% 的客服 case 已经使用 AI。Klarna 的数字更直接:它的 AI Assistant 在 2024 年上半年服务了超过 400 万客户,公司预计每年可以节省 4,000 万美元。
客服用 Token 的这笔账不难算。以前多少人处理多少张工单,现在多少 Token 处理多少张工单,最后有没有转人工、有没有被客户重新打开,都可以数出来。
拒付和争议处理也是一样。Stripe 会收到金融合作伙伴发来的大量自动邮件,过去需要员工一封一封看,再进入系统处理;现在 LLM 可以先读邮件,理解对方要什么,再把要求转成 API 调用。Checkout.com 则表示,以前靠人工完成的被拒交易分发,已经实现 100% 自动化。
这些工作听起来没有“AI 改变金融”那么宏大,但它们很花时间,也很适合消耗 Token。
当 AI 开始看着你的持仓说话
前面说的这些 AI,客户大多看不见。它们躲在代码、审核和客服系统后面干活。Robinhood Cortex 不一样,它直接出现在投资者的手机里。
用户打开一只股票,Cortex 会阅读实时行情、突发新闻、分析师报告、技术指标和 Robinhood 自己的数据,再用普通人能看懂的话解释:这只股票今天为什么在涨,或者为什么在跌。它还会结合用户持仓,告诉他这条新闻为什么和自己的账户有关。
Robinhood 披露,Cortex Digests 到 2026 年第一季度已经被接近 100 万名客户使用。下一步,它还想让用户直接用自然语言买卖股票和加密资产、研究市场、调整账户设置。
到了这里,烧 Token 的已经不只是公司员工。用户每问一个问题,Cortex 每读一份新闻和研报,每结合一次个人持仓重新解释,都要再处理一遍上下文。
真正麻烦的是,一旦 AI 开始替用户操作,犯错的代价就不一样了。新闻讲错了,用户可能只是被误导;股票买错了,亏的可是真金白银。所以 Robinhood 也给 Cortex 划了红线:能看什么、能说什么,哪些操作必须由用户自己确认。
一年一万亿 Token,放在 AI 公司里是什么水平?
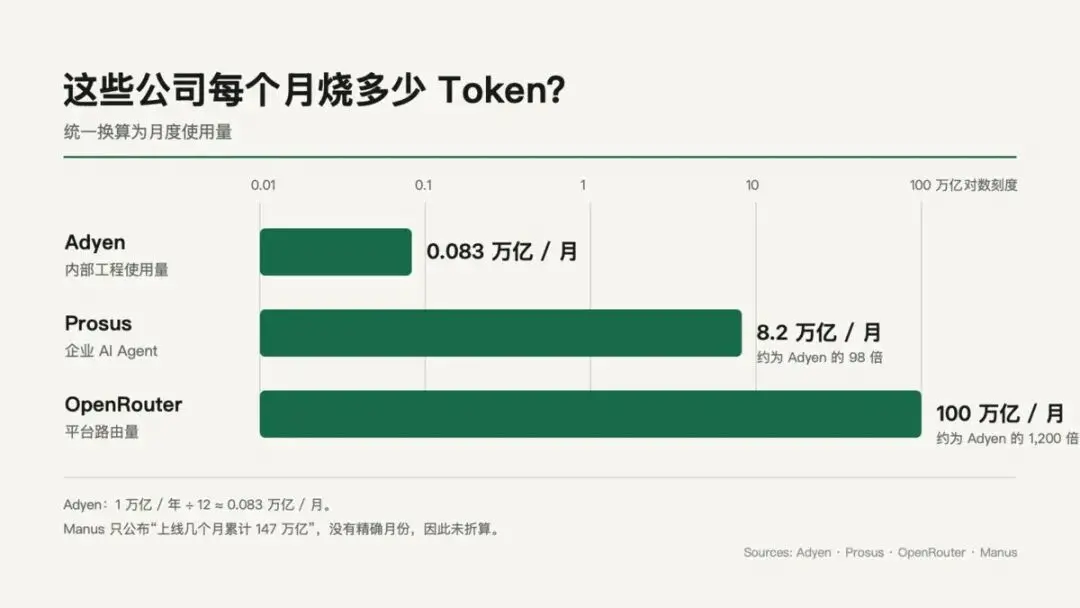
先看 Adyen 自己,大约 1,400 名开发者,一年用掉 1 万亿 Token,平均每个人一年 7.1 亿。如果按 250 个工作日算,就是每人每天约 286 万 Token。这已经不是偶尔让 AI 补几行代码了,而是整天开着 Agent 干活。
但把这个数字放进 AI 行业,计量单位很快就变了。
Manus 的产品上线几个月,累计处理了超过 147 万亿 Token,相当于 Adyen 147 年的量。OpenRouter 现在一个月路由 100 万亿 Token,等于每个月跑掉 100 个 Adyen 的全年用量。当然,这些都是面向大量客户的平台,不能和一家公司内部的工程团队直接比较,但数量级的差距很直观。
再看一家更像普通公司的,Prosus 旗下有大量电商和互联网业务,AI Agent 服务 4 万名员工、500 万合作伙伴和 10 亿用户。它一个月就要用掉 8.2 万亿 Token,差不多每四天跑完 Adyen 一年的量。过去一年,它的 Token 使用量增长了 52 倍。
OpenAI 没说自己一年到底烧掉多少 Token,但它公布了研究人员有多能花。到 2026 年 8 月,一个研究人员一天用掉的算力,按 API 价格折算,中位数已经超过 600 美元。最能用的那 10%,一天超过 7,000 美元。按一年工作 250 天算,一个人就是 15 万美元,重度用户则是 175 万美元。
Anthropic 更直接,它算的不是钱,而是谁干得更久。到 2026 年 8 月,员工手下那些 Agent 加起来,工作时间已经是人类的 6 倍。大部分 Token 都拿去写软件了,结果是平均每名工程师提交代码的速度,半年涨到原来的 5 倍。
Manus 也差不多。联合创始人张涛说,公司曾经有一个月,平均每个人的 AI 开销超过 1 万美元,少数人一个月能花掉七八万美元。这里面不全是 Token 费,但意思很清楚:他们已经不是偶尔问问 AI,而是一个人同时带着一群 Agent 干活。
所以,一万亿 Token 说大很大,说小也小。和 AI 平台比,它只是零头;但对一家支付公司来说,这 1 万亿只发生在约 1,400 名开发者身上,还没有算客服、合规、风控和面向客户的 AI。这样看,Adyen 为一年 10 万亿 Token 做准备,并不算夸张。
Token 可以烧,账还是要算
一万亿 Token 也不等于一张固定金额的账单,不同模型的价格可以差一百倍。按照 2026 年 10 月 28 日 OpenAI 公布的标准 API 价格,假设一万亿 Token 里 80% 是输入、20% 是输出:如果全部使用 GPT-6 Luna,理论费用大约是 18 万美元;如果全部使用 GPT-6 Astra,理论费用大约是 1,800 万美元。
Adyen 实际用了很多不同的模型,也有自己的推理基础设施、语义路由和企业价格,真实账单肯定不是这样简单相乘。同样是一万亿 Token,可以很便宜,也可以很贵。花得多,也不代表用得好。
Token 烧完以后,公司总得回答几个很朴素的问题:多完成了多少没有出事故的代码?少误判了多少正常商户?解决了多少没有再次转人工的客服工单?处理拒付的时候,有没有把正确的材料交给正确的人?
还有一个问题比成本更重要:AI 可以做到哪一步?帮客服查资料,风险不算太高;帮工程师写代码,还可以跑测试、做 review;但如果让 Agent 直接移动资金、冻结账户、拒绝商户,出错的代价就完全不一样了。
至少现在看,支付公司不会把每笔支付都拿去问一次大模型。更现实的分工是:账本继续记账,规则和专用模型继续判断交易,大模型负责阅读、写代码、查资料和处理例外,人留在那些出错以后比较贵的位置。
钱如流水,Token 亦是。
全文完
本文内容仅为个人观察与思考,不构成任何投资或商业建议。请读者结合自身理解与信息来源理性参考。